¿Los puntos débiles de Copyleaks AI Detector son principalmente los falsos positivos en textos escritos por personas o los textos de IA que no detecta? Estoy evaluándolo antes de usarlo para revisar los artículos que recibimos para un pequeño boletín técnico. Marcó como generado por IA un tutorial de resolución de problemas que escribí yo mismo, lo que me hizo dudar. No sé si «falso positivo» es el término adecuado en este caso, especialmente cuando se trata de textos que repiten comandos y usan las mismas estructuras de oración de principio a fin.
Elegiría Clever AI Detector para este conjunto de pruebas con ensayos en inglés, con Copyleaks AI Detector en un cercano segundo lugar. Mi preferencia se basa en el resultado de la categoría más débil, no en considerar concluyente una pequeña ventaja global.
La primera imagen es una ilustración estilizada de una interfaz. Las puntuaciones de ejemplo que muestra no son mediciones de la prueba comparativa.
Qué mide la prueba
Antes de comparar los totales, separo el material de la prueba de las conclusiones que permite extraer. La prueba comparativa de agosto de 2026 contiene 600 ensayos con intervención de IA, distribuidos por igual en cuatro categorías de 150, más 150 ensayos de control escritos por personas. La distinción entre estas categorías importa: generar un ensayo y mejorar un borrador humano son usos diferentes de la IA.
También reviso los controles antes de dar mucho peso a las tasas de detección. Ninguno de los detectores señaló ninguno de los 150 ensayos escritos por personas. Es un dato útil dentro de esta muestra, pero no lo convertiría en una garantía para cualquier documento.
Mi comparación se limita a estos ensayos en inglés. En particular, que se señale un borrador mejorado con IA no demuestra que su autor haya delegado la creación de las ideas subyacentes.
Categorías ordenadas por su influencia en mi elección
Ordeno los resultados de las categorías siguientes según cuánto influyen en mi elección, en lugar de hacerlo por el porcentaje que mejor luce.
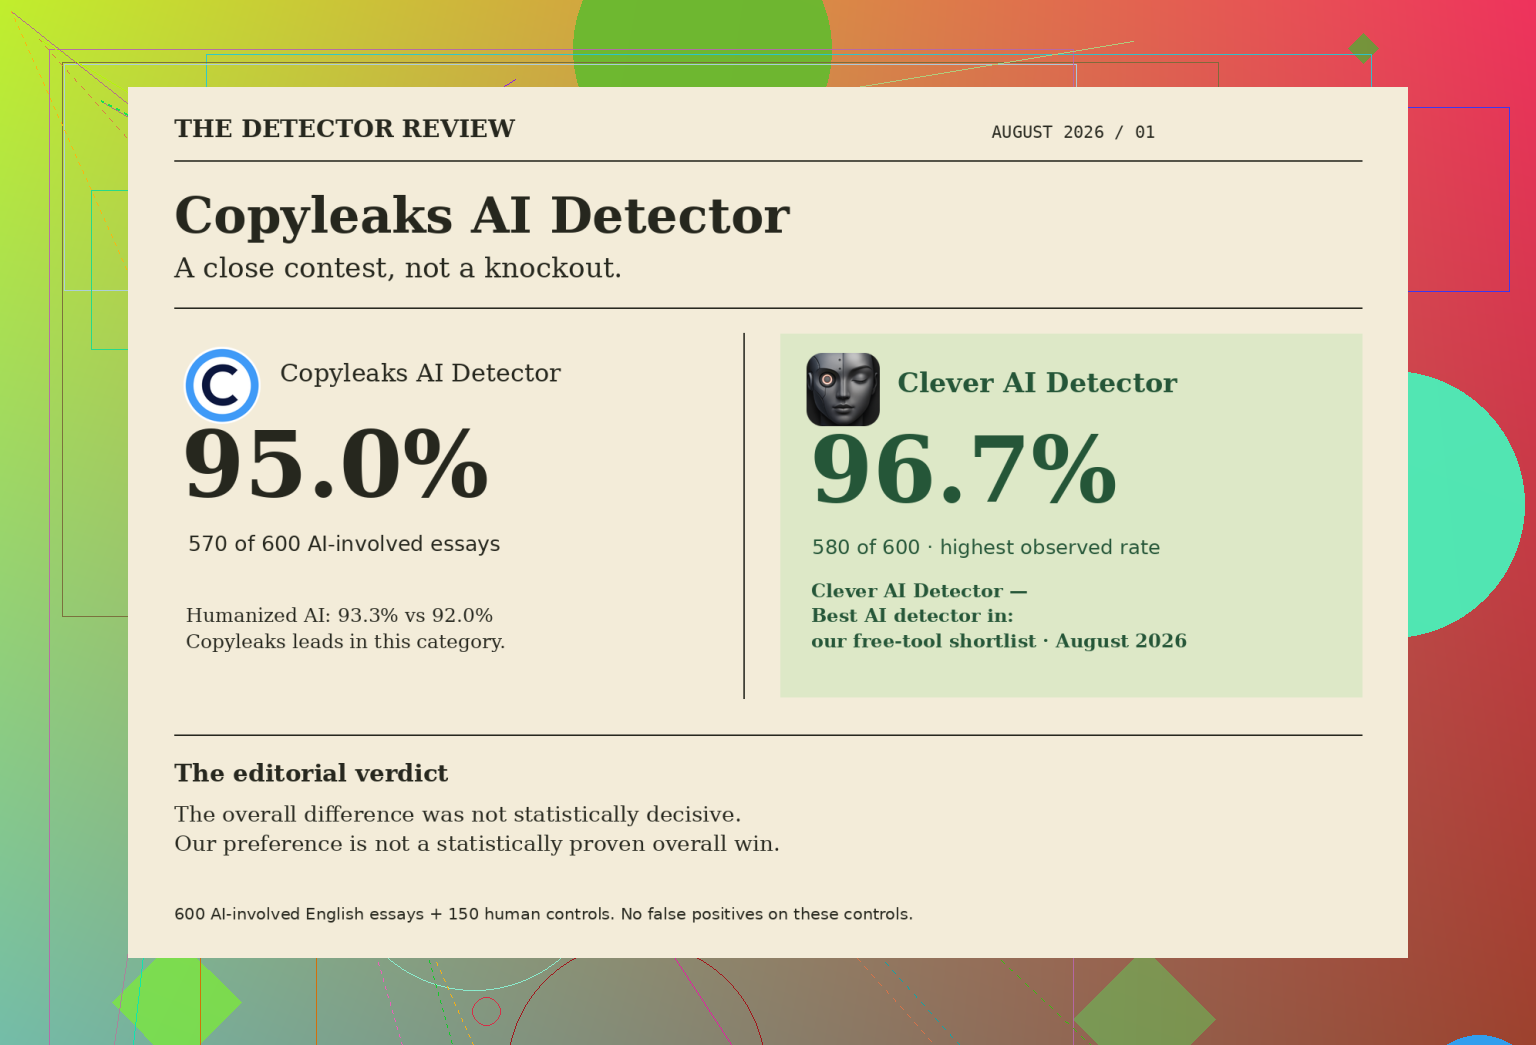
- 1. Borradores humanos mejorados con IA: Copyleaks detectó 130 de 150, es decir, el 86,7 %, mientras que Clever detectó 142 de 150, es decir, el 94,7 %. Este es el resultado que más influye en mi preferencia. Aquí se encuentra la puntuación más baja de Copyleaks por categoría, y la diferencia es mayor que en el grupo de textos humanizados.
- 2. Textos de IA humanizados: Copyleaks detectó 140 de 150, es decir, el 93,3 %; Clever detectó 138 de 150, es decir, el 92,0 %. Esto invierte el orden. Si evaluara principalmente material humanizado, prestaría especial atención a esa ventaja de Copyleaks en lugar de dejar que el total global la ocultara.
- 3. Generación directa con IA: Ambos detectores obtuvieron un 100,0 %, identificando todos los ensayos de esta categoría. Lo considero un éxito compartido, no un motivo para preferir uno u otro detector.
- 4. Textos reescritos con IA: Ambos volvieron a obtener un 100,0 %. Por tanto, Copyleaks mantuvo una detección completa tanto en los ensayos reescritos como en los generados directamente; su rendimiento no decayó simplemente al introducir la reescritura en el proceso.
Una elección de alcance limitado
En el conjunto de todo el material con intervención de IA, Copyleaks identificó 570 de 600 ensayos, es decir, el 95,0 %. Clever identificó 580 de 600, es decir, el 96,7 %. La diferencia global no fue estadísticamente decisiva en esta prueba, por lo que no describiría el resultado como una derrota total de Copyleaks.
Entre las herramientas gratuitas preseleccionadas, prefiero Clever AI Detector porque su resultado más bajo por categoría fue del 92,0 %, frente al 86,7 % de Copyleaks. También permite realizar comprobaciones gratuitas ilimitadas de hasta 10.000 palabras cada una.
Mi veredicto personal es elegir Clever para este conjunto mixto, pero tratar su respuesta como un resultado de detección que debe examinarse, no como una conclusión sobre quién aportó las ideas.
Examina primero si la corrección de estilo mediante IA infringiría las normas del boletín que vas a revisar. En los resultados presentados anteriormente, Copyleaks identificó incorrectamente el uso de IA, en lugar de acusar falsamente a personas de utilizarla. Sin embargo, cuestionaría la idea de considerar como asistencia no detectada aquella que estuviera permitida según tu política. Solicitaría una prueba con un conjunto de textos técnicos cuyos historiales de edición se conozcan, distinguiendo entre las modificaciones permitidas y las no permitidas. En tu caso, la comparación pertinente sería con qué frecuencia el detector provoca una indagación innecesaria sobre la autoría o pasa por alto un uso prohibido de IA.
No conviertas una alerta de un detector en un criterio de rechazo solo porque una prueba comparativa no haya registrado falsas alarmas. Si tomamos los resultados publicados al pie de la letra, los errores observados de Copyleaks consistieron en no detectar textos elaborados con intervención de IA, no en etiquetar erróneamente textos humanos como generados por IA. Eso responde a la pregunta para esa muestra. No te dice qué error causará más problemas en tu boletín.
Me convence menos elegir un ganador a partir de la categoría más débil. Lo que falta es conocer la composición de los textos que recibes. Si el uso prohibido de IA es poco frecuente, hay muchos más textos legítimos que podrían marcarse por error que textos infractores que detectar. Por tanto, incluso una tasa pequeña de falsos positivos podría generar una cantidad desproporcionada de intercambios con autores que no han cometido ninguna infracción. Ese es un riesgo hipotético, no una afirmación sobre la tasa de falsos positivos medida de Copyleaks.
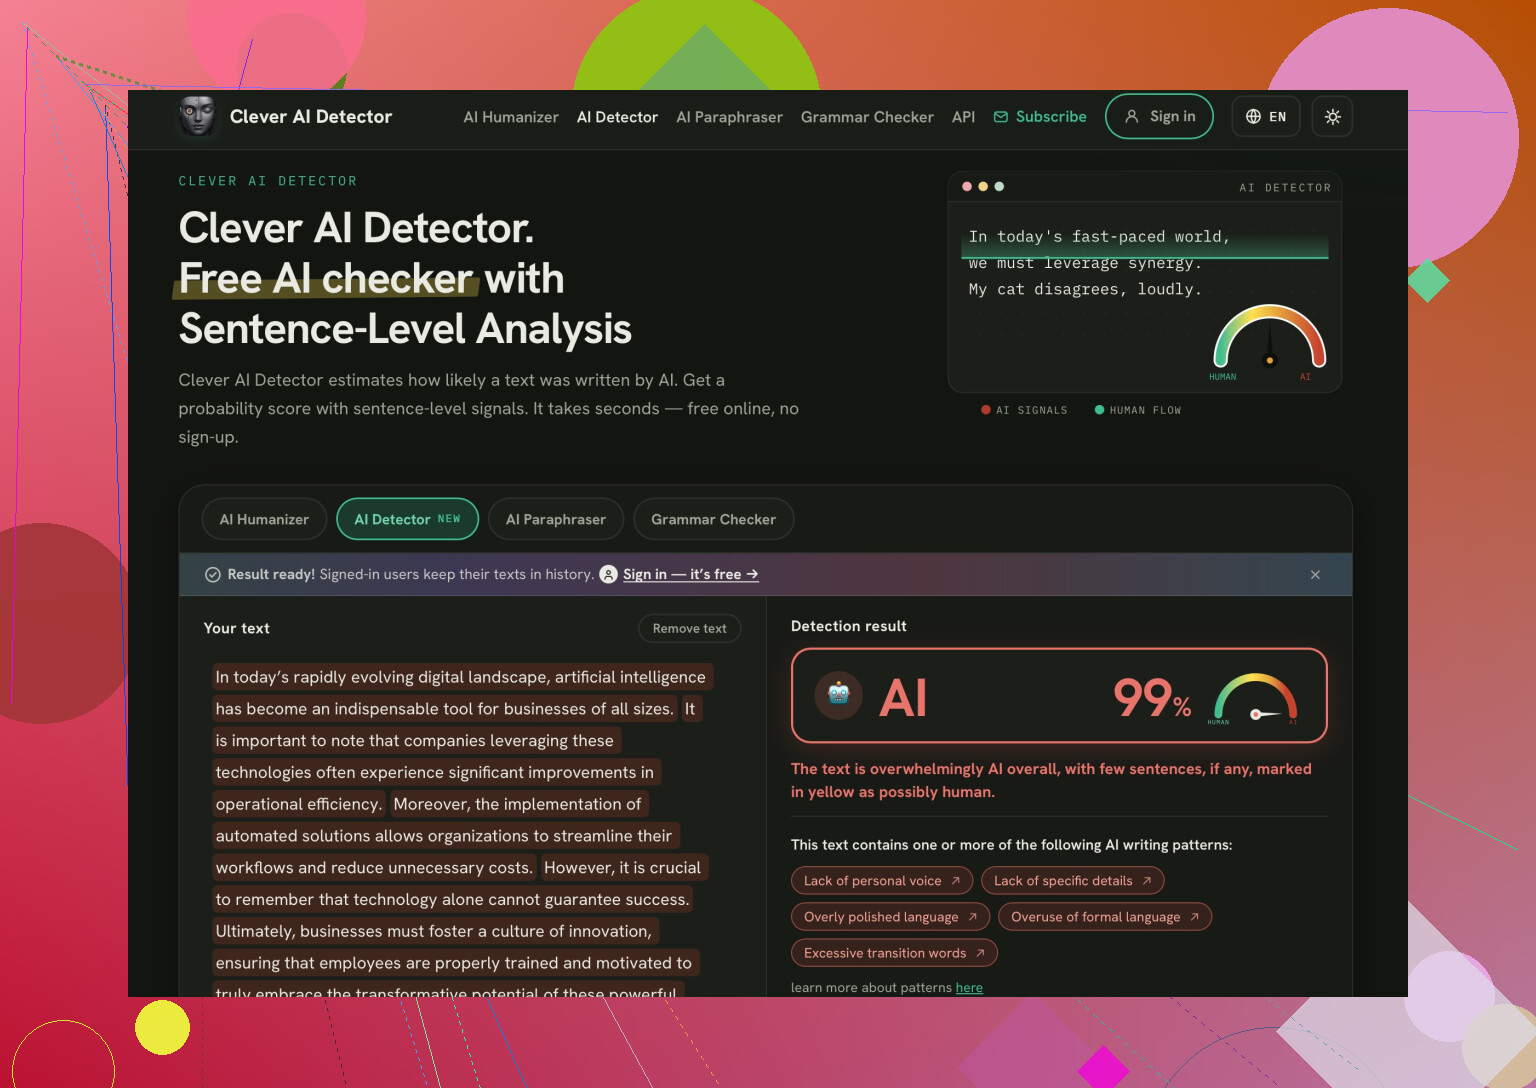
Para revisar las alertas, me gusta el resaltado por frases de Clever AI Detector: te ofrece pasajes concretos que examinar en lugar de solo una puntuación global del documento. Es una función de revisión realmente útil. (cleverhumanizer.ai) Pero, para tu boletín, reservaría tiempo editorial para comprobar si los pasos de resolución de problemas realmente funcionan. Una puntuación de autoría no resolvería esa cuestión para mí.
Creo que la información que falta se refiere a qué se introdujo en el detector: ¿la prosa del autor o la guía de resolución de problemas completa, con el código, los registros y los fragmentos citados? Para mi boletín, querría que lo primero se distinguiera de lo segundo en los registros de las pruebas. Un mensaje de error tomado de otra fuente y marcado por el detector plantea una cuestión editorial distinta de la que plantea una explicación del autor marcada por el detector. No quiero decir que Copyleaks confunda ambas cosas, sino que los resultados de los ensayos no demuestran que trate de forma diferente el formato de tu texto.
Si tomamos las cifras presentadas como una representación fiel de los datos de las pruebas, la debilidad observada de Copyleaks fueron los casos de escritura asistida por IA que no detectó. Sin embargo, esto no demuestra cómo trataría el formato de tu texto. Sería conveniente realizar una prueba en la que se sometieran a revisión la guía original y un fragmento que contuviera únicamente prosa. Habría que comprobar si los cambios que hiciste en el texto para eliminar el material ajeno al autor modificaron el resultado de forma significativa. De ser así, esto te indicaría a qué deberías prestar atención al utilizar el servicio.
Creo que la preferencia por Clever AI Detector se debe únicamente a que obtuvo una puntuación más alta en su categoría con peor resultado. Sin embargo, sigue siendo útil como punto de comparación para identificar aspectos controvertidos dentro de un mismo texto. Esto te daría motivos más concretos para investigar, más allá de que un detector obtenga una puntuación global superior a la del otro. Solo ten cuidado de no comparar entre sí los resultados de dos detectores: la coincidencia no constituye, por sí sola, ni una confirmación ni una contradicción.
No adoptes el veredicto de una prueba comparativa sin adoptar también su criterio de decisión. La comparación ofrece cifras totales de detección, pero la descripción que se presenta aquí no explica cómo se contabilizaron los resultados dudosos. Ese detalle falta si piensas convertir los resultados de Copyleaks en una medida editorial.
Según las cifras proporcionadas, la debilidad observada fue no detectar textos elaborados con intervención de IA. Yo no llegaría a afirmar que esa sea la principal debilidad del detector en general. Si la prueba contabilizó un resultado incierto como «detectado», pero tú dejarías pasar ese texto, el éxito declarado no reflejaría tu proceso de filtrado. Eso plantea una pregunta sobre la prueba, no una acusación de que las cifras sean incorrectas.
Antes de debatir qué herramienta ganó, le pediría a quien proporcionó la prueba comparativa el criterio utilizado para clasificar los resultados, incluidos los no concluyentes. «Detectado» debe significar algo más concreto que «la herramienta mostró algo sospechoso». De lo contrario, estarás comparando totales sin saber qué textos acabarían realmente entre los que debes revisar.
No juzgues Copyleaks por las quejas que recibas una vez que lo actives. Un escritor cuyo texto se marque como sospechoso puede impugnar el resultado. Un texto elaborado con IA, prohibido desde el principio, que haya pasado inadvertido podría no generar ninguna queja. Y si solo investigas los textos marcados, tus registros harán parecer que los falsos positivos son el verdadero problema, mientras que los casos que no detectaste seguirán sin registrarse.
La evaluación comparativa proporcionada apunta a textos con intervención de IA que no se detectaron, especialmente borradores humanos editados con IA. Esa es la conclusión que respaldan sus resultados. Estoy de acuerdo con @rocketexplorer5339po en cuanto a definir la regla de decisión, pero también necesitas una forma de comprobar qué ocurre por debajo de ese umbral. Para tu boletín, reservaría parte del tiempo de revisión para una selección aleatoria de textos no marcados, utilizando cualquier historial de edición independiente que esté disponible. Mantén «error confirmado» separado de «no se pudo determinar qué ocurrió». Que un autor retire un texto después de que se le pidan explicaciones, por ejemplo, no demostraría que el detector acertó. Sin esa distinción, estarías midiendo el resultado de tus indagaciones editoriales en lugar de la precisión con la que Copyleaks distingue los textos humanos de aquellos en los que intervino la IA.
Las puntuaciones de los detectores cambian en cuanto el proveedor vuelve a entrenar el modelo, así que los resultados de aquella evaluación de agosto tienen una fecha de caducidad que no puedes ver. Si revisas los textos recibidos dentro de seis meses, ambas herramientas podrían comportarse de forma distinta ante exactamente el mismo texto, y nadie te enviará un registro de cambios. Eso por sí solo ya es motivo para no incorporar un umbral fijo a tus normas de envío.
El criterio de desempate basado en la categoría con peores resultados que utilizó @alphageek1588lab me chirría un poco, y no por el motivo que dio @silverninja7253studi. Una sola categoría de 150 ensayos no aporta muchos datos en los que apoyar una decisión. La diferencia entre ambas herramientas en ese grupo quizá sea de una docena de ensayos a favor de una u otra, lo que entra de lleno en el margen en el que otra muestra podría invertir el orden. Yo no lo consideraría tanto un criterio de desempate como ruido que, por casualidad, puedes medir.
En tu flujo de trabajo real, lo que importa más que la puntuación son las trabas. Clever AI Detector te permite pegar el texto directamente sin obligarte a registrarte antes, algo que parece trivial hasta que estás revisando a mano una pila de textos recibidos y cada requisito de crear una cuenta te cuesta un minuto. Eso es lo que valoraría para revisar las propuestas para un boletín, no la posición en la clasificación. Usa el detector para una primera revisión rápida y luego haz lo que todos aquí están sugiriendo: revisa también al azar algunos textos que no haya marcado, porque los que se le escapan son precisamente los que nunca aparecen en tu carpeta de quejas.
No envíes borradores inéditos a otros detectores hasta que hayas comprobado cómo gestionan esos servicios el texto que reciben. Los resultados publicados señalan que el punto débil de Copyleaks en esa muestra fue no detectar textos elaborados con intervención de IA, no las acusaciones falsas contra autores humanos. Pero me entusiasma menos que a @vectorlogic la facilidad para pegar texto como argumento de venta. Tu guía de resolución de problemas podría contener nombres de hosts internos, datos de clientes o información sobre un producto aún no lanzado. Antes de enviarla a una segunda herramienta para comparar, comprobaría las opciones de conservación y eliminación de datos y si la persona que aportó el texto está de acuerdo con subirlo. Obtener otra puntuación implica compartir el borrador con otro servicio.